FlameBox를 설치하고 나면 가장 먼저 만나는 질문이 있습니다. "내 PC에서는 어떤 모델을 돌릴 수 있을까?" 모델이 클수록 똑똑하지만, 메모리에 다 들어가지 않으면 아예 실행되지 않거나 매우 느려집니다.
이 글에서는 내 PC의 메모리를 확인하는 방법부터, 메모리 크기별로 FlameAI 카탈로그에서 바로 받을 수 있는 모델을 정리했습니다.
먼저 알아 둘 세 가지
1. GPU로 돌릴지, CPU로 돌릴지
모델은 GPU 메모리(VRAM)에 올려 돌리거나, GPU가 없으면 시스템 메모리(RAM)만으로 돌릴 수 있습니다. 둘 중 하나만 충분하면 됩니다.
- GPU 실행: 훨씬 빠릅니다. 대화형 서비스라면 GPU를 권장합니다.
- CPU 실행: GPU 없이도 동작하지만 답이 느리게 나옵니다. 작은 모델이나 가끔 쓰는 작업에 적합합니다.
VRAM이 조금 모자라면 모델의 일부만 GPU에 올리고 나머지는 RAM에 둘 수도 있습니다. 속도는 그만큼 느려집니다. 방법은 Cortex 만들기와 파라미터 이해하기의 n_gpu_layers 설명을 참고하세요.
2. 양자화(Q8, Q5, Q2)
FlameAI의 모델은 모두 양자화된 GGUF 파일입니다. 양자화는 모델의 숫자를 더 적은 비트로 줄여 담는 방식입니다.
| 표기 | 크기 | 품질 |
|---|---|---|
| Q8 | 원본의 약 절반 | 원본과 거의 차이 없음 |
| Q5 | Q8보다 약 30% 작음 | 대부분의 작업에서 충분 |
| Q2 | 가장 작음 | 품질이 눈에 띄게 낮아질 수 있음 |
같은 메모리라면 "작은 모델의 Q8"과 "큰 모델의 Q2·Q5" 중에서 고르게 됩니다. 정답은 작업마다 다르니, 두 가지를 다 받아 비교해 보는 것이 가장 확실합니다.
3. 컨텍스트 길이도 메모리를 씁니다
모델 파일 말고도, 대화 내용을 기억하는 데(KV 캐시) 메모리가 더 듭니다. 한 번에 다루는 글이 길수록(n_ctx가 클수록) 더 많이 씁니다. 이 글의 표는 GPU는 컨텍스트 32K, CPU는 8K 기준입니다. 메모리가 빠듯하면 컨텍스트를 줄여서 맞출 수 있습니다.
내 PC의 메모리 확인하기
| OS | 확인 방법 |
|---|---|
| Windows | 작업 관리자(Ctrl + Shift + Esc) › 성능 탭 — 메모리에서 RAM, GPU에서 "전용 GPU 메모리"(VRAM)를 봅니다. |
| Linux | RAM은 free -h, NVIDIA GPU의 VRAM은 nvidia-smi로 확인합니다. |
RAM은 운영체제와 다른 프로그램도 함께 쓰므로, 표의 값보다 몇 GB 여유가 있어야 편하게 돌아갑니다.
메모리별 추천 모델
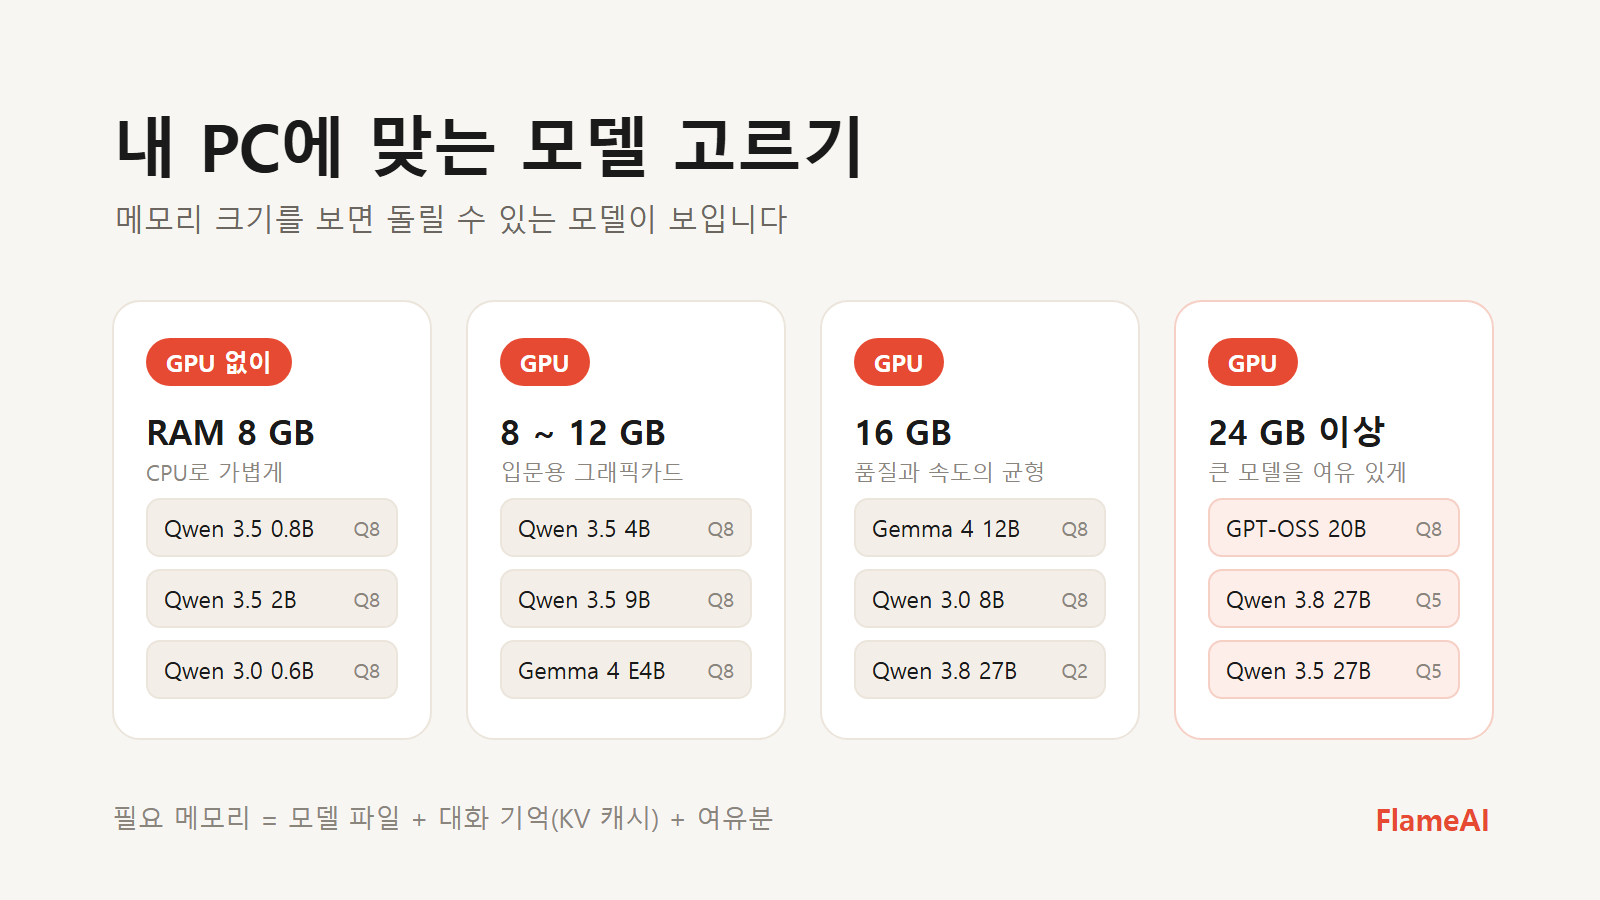
FlameAI 카탈로그에서 지금 바로 받을 수 있는 텍스트 모델을 메모리 크기별로 나눴습니다. 필요한 메모리는 모델 파일 크기에 KV 캐시와 여유분을 더한 추정치입니다.
GPU 없이 (RAM 8 GB 정도)
- Qwen 3.5 0.8B (Q8, 1.2 GB) — 가장 가볍게 시작하기 좋습니다.
- Qwen 3.5 2B (Q8, 2.8 GB)
- Qwen 3.0 0.6B (Q8, 0.8 GB)
- Qwen 3.5 4B (Q8_0, 4.5 GB) — RAM 6 GB 이상 여유가 있으면 이쪽이 답변 품질이 더 낫습니다.
GPU 8 GB
- Qwen 3.5 4B (Q8_0) — VRAM 약 7 GB
- 더 작은 Qwen 3.5 0.8B·2B도 여유 있게 돌아갑니다.
GPU 12 GB
- Qwen 3.5 9B (Q8_0, 9.5 GB) — VRAM 약 12 GB
- Gemma 4 E4B (Q8_K_XL, 8.7 GB) — VRAM 약 12 GB
GPU 16 GB
- Qwen 3.0 8B (Q8_0, 8.7 GB) — VRAM 약 16 GB
- Gemma 4 12B (Q8_0, 12.7 GB) — VRAM 약 16 GB
- Qwen 3.8 27B (Q2_K_XL, 9.8 GB) — VRAM 약 14 GB. 큰 모델을 작게 줄인 버전입니다.
- GPT-OSS 20B (Q8_K_XL, 13.2 GB) — 컨텍스트를 16K 정도로 줄이면 16 GB에 들어갑니다.
GPU 24 GB 이상
- GPT-OSS 20B — 컨텍스트 32K로 여유 있게
- Gemma 4 12B (Q8_K_XL, 13.6 GB)
- Qwen 3.8 27B (Q5_K_XL, 20.9 GB) · Qwen 3.5 27B (Q5_K_M, 19.6 GB) — VRAM 약 26 GB라 24 GB GPU에서는 컨텍스트를 줄여야 하고, 32 GB GPU에서는 여유 있게 돌아갑니다.
한눈에 보기
| 모델 | 양자화 | 파일 크기 | GPU 실행 VRAM | CPU 실행 RAM |
|---|---|---|---|---|
| Qwen 3.0 0.6B | Q8_K_XL | 0.8 GB | 5 GB 이상 | 2 GB 이상 |
| Qwen 3.5 0.8B | Q8_K_XL | 1.2 GB | 2 GB 이상 | 2 GB 이상 |
| Qwen 3.5 2B | Q8 | 2.8 GB | 4 GB 이상 | 4 GB 이상 |
| Qwen 3.5 4B | Q8_0 | 4.5 GB | 7 GB 이상 | 6 GB 이상 |
| Qwen 3.0 8B | Q8_0 | 8.7 GB | 16 GB 이상 | 12 GB 이상 |
| Gemma 4 E4B | Q8_K_XL | 8.7 GB | 12 GB 이상 | 10 GB 이상 |
| Qwen 3.5 9B | Q8_0 | 9.5 GB | 12 GB 이상 | 12 GB 이상 |
| Qwen 3.8 27B | Q2_K_XL | 9.8 GB | 14 GB 이상 | 12 GB 이상 |
| Gemma 4 12B | Q8_0 | 12.7 GB | 16 GB 이상 | 16 GB 이상 |
| GPT-OSS 20B | Q8_K_XL | 13.2 GB | 18 GB 이상 | 16 GB 이상 |
| Gemma 4 12B | Q8_K_XL | 13.6 GB | 18 GB 이상 | 16 GB 이상 |
| Qwen 3.5 27B | Q5_K_M | 19.6 GB | 26 GB 이상 | 24 GB 이상 |
| Qwen 3.8 27B | Q5_K_XL | 20.9 GB | 26 GB 이상 | 24 GB 이상 |
Qwen 3.0 0.6B는 파일이 작은데도 GPU 실행 VRAM이 5 GB로 큰 편입니다. 컨텍스트 32K 기준이라 KV 캐시가 차지하는 몫이 크기 때문입니다. 컨텍스트를 줄이면 훨씬 적게 씁니다. 반대로 Qwen 3.5·3.8은 구조상 KV 캐시가 작아 긴 컨텍스트에도 부담이 적습니다.
어떤 모델부터 써 볼까요
- 처음이라면: Qwen 3.5 2B나 4B로 시작해 보세요. 작고 빠르면서 한국어 대화가 됩니다. 설치와 API 호출이 잘 되는지 확인하기에도 좋습니다.
- 답변 품질이 중요하다면: 메모리가 허락하는 가장 큰 모델을 고르세요. 16 GB GPU라면 Gemma 4 12B나 Qwen 3.0 8B를, 24 GB 이상이라면 GPT-OSS 20B나 27B급 Qwen을 권합니다.
- 분류·판정만 필요하다면: 문장을 생성하지 않는 판정 모델 Laya(약 450 MB)나, 이미 만든 LLM Cortex의
choiceAPI를 쓰면 됩니다. Laya로 빠르게 판정하기를 참고하세요.
모델별 자세한 사양, 권장 파라미터, 다른 크기의 필요 메모리는 지원 모델의 각 모델 상세 화면에 정리되어 있습니다.
다음 단계
모델을 골랐다면 마이페이지 › FlameBox 상세 화면에서 모델을 내려받고 Cortex를 만들 차례입니다. Cortex 만들기와 파라미터 이해하기에서 내 메모리에 맞게 설정하는 방법을 이어서 살펴봅니다.