AI에게 "이 문의는 어느 부서로 보내야 해?"라고 물을 때마다 긴 답변을 생성하게 할 필요는 없습니다. 보기 중 하나만 고르면 되는 질문이라면, 문장을 쓰지 않고 보기마다 확률만 계산하는 모델이 훨씬 빠르고 다루기도 쉽습니다.
FlameAI가 지원하는 Laya가 바로 그런 판정 전용 모델입니다. 이 글에서는 Laya가 무엇이고 언제 쓰면 좋은지, FlameAI에서 어떻게 호출하는지, 그리고 고객 문의 분류부터 AI 에이전트의 분기 판단, 근거 기반 사실 확인까지 실전 패턴을 차례로 살펴봅니다. 제작사 문서와 해외 사용자들의 리뷰에서 공통으로 강조하는 주의점도 함께 정리했습니다.
Laya는 어떤 모델인가요
Laya는 Convai Innovations가 Apache-2.0 라이선스로 공개한 판정형(decision) 모델입니다. ModernBERT 인코더 위에 판정용 블록을 얹은 약 4억 2천만 파라미터 크기로, 일반 채팅 LLM과 비교하면 매우 작습니다.
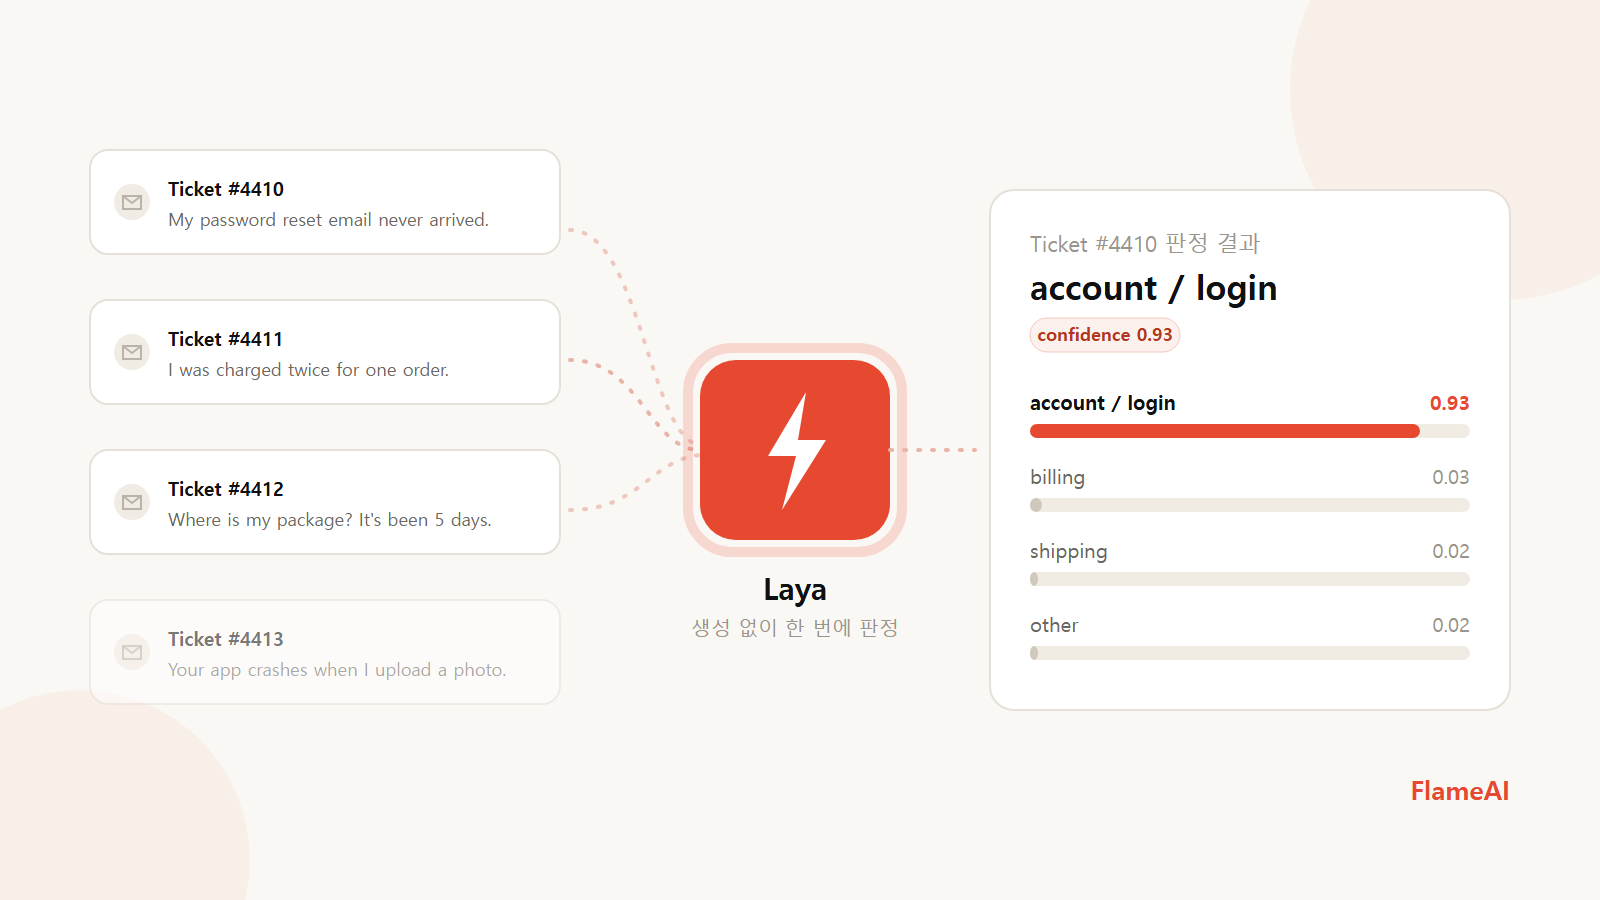
사용법은 단순합니다. 판단할 내용(query)과 선택지(choices)를 주면, 글 전체를 한 번에 읽고 선택지마다 확률을 돌려줍니다.
| 채팅 LLM에게 분류를 시킬 때 | Laya로 판정할 때 | |
|---|---|---|
| 동작 | 답을 한 글자씩 생성한 뒤 그 문장을 해석 | 한 번의 계산으로 모든 선택지의 점수를 냄 |
| 결과 | 문장 (형식이 흔들릴 수 있음) | 선택지별 확률 (합계 1) |
| 엉뚱한 답 | 보기에 없는 답을 지어낼 수 있음 | 항상 주어진 보기 중에서만 고름 |
| 속도·자원 | 모델이 크고 생성 시간만큼 느림 | 작고 빠름, CPU에서도 실행 가능 |
해외에서는 이런 모델을 사람의 직관적인 판단에 빗대어 "System 1" 모델이라고 부릅니다. 깊이 생각해서 글을 쓰는 LLM(System 2) 앞에 서서, 들어오는 요청을 재빨리 분류하는 문지기 역할에 잘 맞는다는 뜻입니다.
먼저 알아 둘 점 — Laya는 "만능 분류기"가 아닙니다
제작사와 해외 리뷰어들이 한목소리로 강조하는 부분이라 먼저 짚고 넘어갑니다.
- 설정 없이 바로 쓰면(zero-shot) 정확도가 높지 않습니다. 제작사가 공개한 벤치마크에서 기본 영어 모델은 0.362였고, 같은 데이터로 추가 학습한 모델이 0.766이었습니다. 리뷰어들은 Laya를 "곧바로 쓰는 판정 엔진이 아니라, 특화시키기 좋은 빠른 기반"이라고 평가합니다.
- 확률을 실제보다 자신 있게 내는 경향이 있습니다. 그래서 "0.9 이상이면 자동 처리" 같은 기준은 반드시 내 데이터로 확인한 뒤 정해야 합니다.
- FlameAI에서 제공하는 Laya는 영어 모델입니다. 한국어 문장은 정확도가 떨어집니다. 사내 테스트에서도 영어 라우팅·문맥 판정은 정확했지만 한국어는 약했습니다. 한국어 업무라면 아래 "한국어 데이터는 이렇게" 절을 참고하세요.
그래서 이 글의 모든 패턴은 "Laya가 빠르게 1차 판정 → 확신이 낮으면 사람이나 LLM에게 넘기기"를 기본 구조로 합니다.
FlameAI에서 Laya 준비하기
준비 과정은 일반 모델과 같습니다. FlameBox 설치와 첫 호출이 처음이라면 첫 API 호출하기를 먼저 봐 주세요.
- 판정 모델을 지원하는 최신 FlameBox를 준비합니다.
- 마이페이지 › FlameBox 상세 화면에서 Laya (Q8_0) 모델을 내려받습니다. 크기는 약 450MB라 금방 받아집니다.
- Laya 모델로 Cortex를 만듭니다. 이 글에서는 Cortex ID를
laya-router로 가정합니다.
FlameBox 상세 화면에서 Laya (Q8_0) 모델을 내려받는 모습 (카탈로그 선택 또는 다운로드 완료 목록)
Cortex 생성 창에서 Laya 모델을 고르고 Cortex ID를 laya-router로 입력한 모습
Laya Cortex는 판정 전용입니다. 대화 생성(messages) 같은 요청은 받지 않고, choice 요청만 처리합니다. 메모리도 1GB 남짓이면 충분해서, 채팅용 LLM Cortex 옆에 하나 더 띄워 두기 부담이 없습니다.
첫 판정 요청
판정은 choice 엔드포인트로 보냅니다. 주소와 Secret Key는 마이페이지 › My API에서 확인합니다.
curl -X POST https://api-3.flameai.im/Nx7bQ2mZ/cortex/laya-router/choice \
  -H "Authorization: Bearer YOUR_SECRET_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "instruction": "Which team should handle this ticket?",
    "query": "My password reset email never arrived.",
    "choices": ["billing", "account / login", "shipping", "other"]
  }'
응답은 다음과 같은 형태입니다. (확률과 시간은 형식을 보여 주기 위한 예시 값입니다.)
{
  "cortexId": "laya-router",
  "method": "laya",
  "best_choice": "account / login",
  "confidence": 0.93,
  "probabilities": { "billing": 0.03, "account / login": 0.93, "shipping": 0.02, "other": 0.02 },
  "truncated": false,
  "usage": { "input_tokens": 41, "elapsed_ms": 20, "passes": 1 }
}위 curl을 실제로 실행한 터미널 화면 — best_choice, confidence, probabilities, elapsed_ms가 보이게 (Secret Key는 가려서)
| 필드 | 뜻 |
|---|---|
instruction | 판정 질문. 생략하면 "질문에 가장 맞는 보기를 고르라"는 기본 문장이 쓰입니다. |
query | 판단할 내용. 문자열은 물론 JSON 객체도 넣을 수 있습니다. |
choices | 선택지 목록 (2개 이상, 중복 불가) |
best_choice / confidence | 가장 확률이 높은 선택지와 그 확률 |
probabilities | 선택지별 확률 (요청한 순서 그대로, 합계 1) |
truncated | 질문과 선택지가 너무 길어 일부가 잘렸으면 true |
temperature는 보내지 않는 것을 권장합니다. Laya 모델 파일에는 선택지 개수별로 맞춰 둔 보정 값이 들어 있어서, 생략하면 FlameBox가 그 값을 자동으로 씁니다.
Python으로 감싸 두기
여러 패턴에서 재사용할 수 있게 작은 함수를 하나 만들어 둡니다.
import requests

API_BASE   = "https://api-3.flameai.im/Nx7bQ2mZ"   # My API의 API 주소
SECRET_KEY = "fai_xxxxxxxx"                         # My API의 Secret Key

def choose(instruction, query, choices, cortex="laya-router"):
    res = requests.post(
        f"{API_BASE}/cortex/{cortex}/choice",
        headers={"Authorization": f"Bearer {SECRET_KEY}"},
        json={"instruction": instruction, "query": query, "choices": choices},
        timeout=60,
    )
    data = res.json()
    if "error" in data:
        raise RuntimeError(f'{data["error"]["code"]}: {data["error"]["message"]}')
    return data
패턴 1. 고객 문의 자동 분류 — 확신이 낮으면 사람에게
가장 대표적인 쓰임입니다. 핵심은 확률이 충분히 높을 때만 자동으로 보내고, 애매하면 사람이 확인하는 대기열로 넘기는 것입니다.
TEAMS = ["billing", "account / login", "shipping", "technical problem", "other"]

def route_ticket(text, threshold=0.8):
    r = choose("Which team should handle this ticket?", text, TEAMS)
    if r["confidence"] >= threshold:
        return r["best_choice"]          # 자동 배정
    return "needs-review"                # 사람이 확인

print(route_ticket("I was charged twice for one order."))
threshold 값은 처음부터 정답이 있는 것이 아닙니다. 아래 "도입 전 검증" 절의 방법으로 내 데이터에 맞춰 정하세요.
패턴 2. 한 문의에서 여러 가지를 동시에 판단하기
Laya 원본은 한 번에 여러 질문을 받을 수 있지만, FlameAI의 choice는 요청 하나에 질문 하나입니다. 대신 판정이 빠르므로 질문별로 나눠 보내면 됩니다. query에는 이메일처럼 구조가 있는 데이터를 JSON 객체 그대로 넣을 수 있습니다.
email = {
    "from": "user@acme.com",
    "subject": "Duplicate charge on invoice #4411",
    "body": "We were billed twice. Please refund or we cancel.",
}

team    = choose("Which team should handle this email?", email,
                 ["billing", "technical problem", "sales", "other"])
urgency = choose("How urgent is this email?", email,
                 ["routine", "soon", "blocking"])
churn   = choose("Does the customer threaten to cancel?", email,
                 ["yes, the customer threatens to cancel",
                  "no, there is no cancellation threat"])

print(team["best_choice"], urgency["best_choice"], churn["best_choice"])
세 번째 질문처럼 "예/아니오"를 물을 때는 선택지를 yes/no 한 단어보다 무엇에 대한 예/아니오인지 문장으로 쓰는 편이 안정적입니다. 제작사도 모델이 내용보다 보기 이름에 끌려가는 경우가 있다고 안내합니다.
Cortex 하나는 한 번에 요청 하나를 처리합니다. 동시에 들어오는 요청이 많다면 Laya Cortex를 여러 개 만들어 나눠 보내세요. 이미 계산 중인 Cortex에 보내면 cortex_inferring 오류가 돌아옵니다.
패턴 3. AI 에이전트의 "다음 행동" 고르기
에이전트를 만들다 보면 "지금 검색을 할지, 사용자에게 되물을지, 바로 답할지"를 매번 정해야 합니다. 이 분기 판단을 큰 LLM에게 맡기면 느리고 자원도 많이 씁니다. 이럴 때 Laya를 앞에 두면 됩니다.
ACTIONS = [
    "answer directly",
    "search the knowledge base first",
    "ask the user a clarifying question",
    "hand over to a human agent",
]

def next_action(user_message):
    r = choose("What should the assistant do next?", user_message, ACTIONS)
    return r["best_choice"], r["confidence"]

print(next_action("What were our Q3 sales numbers in the Busan branch?"))
판단은 Laya가 빠르게 하고, 실제 답변 작성은 LLM Cortex의 messages가 맡는 구조입니다.
패턴 4. 콘텐츠 검수 — 막지 말고 표시하기
게시글이나 댓글이 정책에 어긋나는지 1차로 걸러낼 때도 쓸 수 있습니다. 해외 리뷰에서 강조하는 원칙은 "예측은 행동이 아니다"입니다. 높은 확률이 나왔다고 바로 삭제하지 말고, 검토 대기열에 올리는 식으로 쓰는 것이 안전합니다.
r = choose(
    "Does this comment violate the community policy?",
    comment_text,
    ["no, the comment is acceptable",
     "yes, it contains harassment or hate speech",
     "yes, it is spam or advertising"],
)
if not r["best_choice"].startswith("no") and r["confidence"] >= 0.7:
    flag_for_review(comment_text, r)     # 삭제가 아니라 검토 요청
패턴 5. 근거를 주고 사실 확인하기
Laya에게 근거 없이 "이 말이 사실이야?"라고 물으면 대체로 "거짓" 쪽으로 기웁니다. 모델이 세상의 지식을 외우고 있는 것이 아니기 때문입니다. 대신 근거 문서(Reference)와 확인할 주장(Claim)을 함께 넣으면 판정이 뚜렷해집니다. 사내 테스트에서도 이 형식으로 바꾸자 참과 거짓이 분명하게 갈렸습니다.
query = """Reference: Our refund policy allows returns within 30 days of delivery.
Items must be unused and in the original packaging.
Claim: A customer can return a used item 10 days after delivery."""

r = choose("Is the claim supported by the reference?", query,
           ["supported by the reference", "contradicted by the reference"])
print(r["best_choice"], r["confidence"])
검색(RAG)으로 찾은 문서를 Reference에 넣고, LLM이 만든 답변을 Claim에 넣으면 "AI 답변이 근거와 맞는지" 자동으로 점검하는 장치가 됩니다.
패턴 6. Laya + LLM — 빠른 판정과 깊은 판단 나누기
앞의 패턴들을 합치면 다음과 같은 구조가 됩니다.
- 모든 요청은 먼저 Laya가 판정합니다. 가볍고 빠른 단계입니다.
- 확신이 높으면 그대로 처리합니다.
- 확신이 낮으면 같은 요청을 LLM Cortex의
choice로 다시 보내 한 번 더 판정하거나,messages로 자세히 분석하게 합니다.
FlameAI의 choice는 LLM Cortex에서도 요청 형식이 똑같습니다. Cortex ID만 바꾸면 됩니다.
def classify(text, choices, instruction):
    r = choose(instruction, text, choices, cortex="laya-router")
    if r["confidence"] >= 0.85:
        return r
    # 애매하면 LLM Cortex 로 한 번 더 — 요청 형식은 그대로
    return choose(instruction, text, choices, cortex="my-assistant")
응답의 method 값을 보면 어느 쪽이 판정했는지 알 수 있습니다. Laya는 laya, LLM Cortex는 llm_label로 옵니다. 대부분의 요청을 가벼운 Laya가 처리하고 어려운 일부만 LLM이 맡으므로, FlameBox 자원을 훨씬 효율적으로 쓸 수 있습니다.
한국어 데이터는 이렇게
FlameAI의 Laya는 영어 모델이라 한국어 문장을 그대로 넣으면 정확도가 떨어집니다. 다음 방법 중 하나를 고르세요.
- LLM Cortex의
choice를 쓰기: 한국어를 잘하는 LLM Cortex에 같은 형식으로 보내면 됩니다. Laya보다는 느리지만 문장을 생성하지 않고 확률만 계산하므로 일반 대화보다 훨씬 빠릅니다. 선택지는 2~26개까지 쓸 수 있고, 보기 순서에 따른 치우침을 줄여 주는debias옵션도 있습니다. - 질문과 선택지는 영어로 쓰기: 한국어 원문이라도 질문과 선택지만 영어로 쓰면 결과가 나아질 수 있습니다. 다만 업무마다 차이가 크므로 반드시 검증한 뒤 사용하세요.
제작사는 100개 이상의 언어를 지원하는 다국어 모델(laya-multilingual)도 공개했지만, 현재 FlameAI 카탈로그에는 들어 있지 않습니다.
선택지를 잘 쓰는 요령
- 질문은 구체적으로: "Classify this."보다 "Which team should handle this ticket?"이 낫습니다.
- 선택지끼리 겹치지 않게: "billing"과 "payment"처럼 의미가 겹치면 확률이 나뉘어 둘 다 낮게 나옵니다.
- 선택지는 짧게, 개수는 적게: 질문과 선택지를 합쳐 약 192토큰 안에 들어가야 합니다. 넘치면 선택지가 잘리고 응답의
truncated가true가 됩니다. 실용적으로는 20개 이내를 권장합니다. - 선택지가 많으면 두 단계로: 77개 분류처럼 선택지가 많으면 정확도가 크게 떨어진다는 것이 제작사 측정 결과입니다. "대분류 5개 → 해당 대분류 안의 소분류"처럼 나눠서 두 번 물으세요.
- "기타"를 넣어 두기: 어떤 보기에도 해당하지 않는 입력이 들어올 수 있으므로
other를 하나 두면 엉뚱한 보기로 끌려가는 일을 줄일 수 있습니다. - 판단 대상은 짧게: 제작사는 영어 모델을 짧은 입력(약 512토큰) 기준으로 안내합니다. 긴 문서는 핵심 부분만 잘라 넣거나, 먼저 요약한 뒤 판정하세요.
도입 전 검증 — 이것만은 꼭
해외 리뷰에서 공통으로 권하는 도입 절차를 정리하면 다음과 같습니다.
- 정답이 있는 예시를 200개 이상 모읍니다. 실제 문의와, 사람이 정한 정답 분류를 짝지어 둡니다.
- Laya로 전부 판정해 정확도를 잽니다. 전체 정확도뿐 아니라 어떤 분류끼리 자주 헷갈리는지도 봅니다.
confidence구간별로 정확도를 봅니다. 예를 들어 0.9 이상일 때 95%가 맞는다면, 그 값을 자동 처리 기준으로 삼을 수 있습니다.- 먼저 "그림자 모드"로 돌립니다. 기존 방식은 그대로 두고 Laya 결과를 옆에 기록만 하면서 실제 데이터에서의 성능을 확인합니다.
- 주기적으로 다시 확인합니다. 문의 유형이 바뀌면 정확도도 바뀝니다.
이 과정을 거쳐 정확도가 부족하다면 선택지를 다듬거나, 패턴 6처럼 LLM Cortex와 함께 쓰는 구조로 보완하세요.
정리 — 언제 Laya를 쓸까요
| 이럴 때 Laya | 이럴 때 LLM Cortex |
|---|---|
| 보기가 정해진 분류·판정 | 답을 글로 써야 하는 작업 |
| 요청이 많고 빨라야 할 때 | 요청은 적지만 깊은 이해가 필요할 때 |
| 영어 데이터 | 한국어 데이터 (choice도 가능) |
| 확률로 자동/보류를 나누고 싶을 때 | 애매한 경우의 2차 판단 |